本文是AI工厂系列博文之一。阅读完本文后,欢迎继续浏览本系列的其他文章。
- 面向AI工厂的检索增强生成(RAG)›
- 优化AI工厂数据摄取的流量管理 ›
- 优化边缘数据源与AI工厂的连接 ›
- 多云可扩展性和灵活性为AI工厂提供支持 ›
- NVIDIA BlueField DPU对AI工厂的赋能与意义 ›
- 面向AI工厂的API保护:迈向AI安全的第一步 ›
- 网络分段对AI工厂的重要性 ›
- AI工厂打造前沿的现代应用:AI应用 ›
2022年11月ChatGPT发布时,我们提出的问题和输入的提示词都很简单:“给我讲一个关于X的故事”和“围绕主题Z写一段人物A与人物B之间的故事。”当时,我们通过这些问题以及与GPT-3.5的初步互动,尝试了解这项新兴热门技术会如何影响日常生活。如今,到了2024年末,AI已成为我们生活中的助力:帮助我们调试和编写代码、整理和汇总数据,以及驾驶自动驾驶汽车,这些只是其中的几个例子。这些都是现代AI工厂的产出,而我们才刚刚起步。
本文是AI工厂系列文章的首篇,将探讨AI工厂的组成部分,以及各要素如何协同运作,规模化生成AI驱动的解决方案。
AI工厂的定义
随着AI不断发展,AI工厂这一概念应运而生,用于类比AI模型和服务的创建、优化与部署过程。传统制造工厂将原材料加工为成品,而AI工厂与之类似,通过对存储、网络和计算资源的大规模投入,满足大规模、高性能的训练和推理需求。
“AI工厂是在存储、网络和计算方面的大规模投入,用于满足大规模、高性能的训练和推理需求。”
在这些工厂内,由服务器、图形处理器(GPU)、数据处理器(DPU)和专用硬件组成的网络协同运行,处理海量数据,执行复杂算法来训练AI模型,使其达到较高的准确性和效率。这些基础设施经过精心设计,可满足训练大规模模型并将其部署用于实时推理所需的庞大算力需求。它们采用先进的存储解决方案来管理和检索海量数据集,确保数据顺畅流动。
负载均衡和网络优化可充分提升性能和资源利用率,防止出现瓶颈并确保可扩展性。通过这种软硬件组件协同编排,AI工厂能够构建前沿AI模型并持续改进,以适应新数据和不断变化的需求。归根结底,AI工厂体现了AI开发的工业化,为下一代智能应用提供所需的强大基础设施。
AI工厂为何重要?
正如NVIDIA首席执行官黄仁勋在Salesforce的Dreamforce 2024大会上所说:“历史上,计算机技术的发展速度从未超过摩尔定律。”他接着说道:“如今,我们的发展速度远超摩尔定律,可以说,轻松就达到了摩尔定律的平方。”
随着AI投资成为形成市场差异化优势和提升运营效率的关键因素,规模化部署AI正变得日益重要。为此,组织需要持续构建和优化模型,并整合知识库与实时数据。AI工厂这一概念强调,AI应是一项持续投入,而非一次性工作。它为组织提供了将AI计划落地运营的框架,使组织能够更灵活地适应不断变化的业务和市场需求。
AI工厂的组成部分
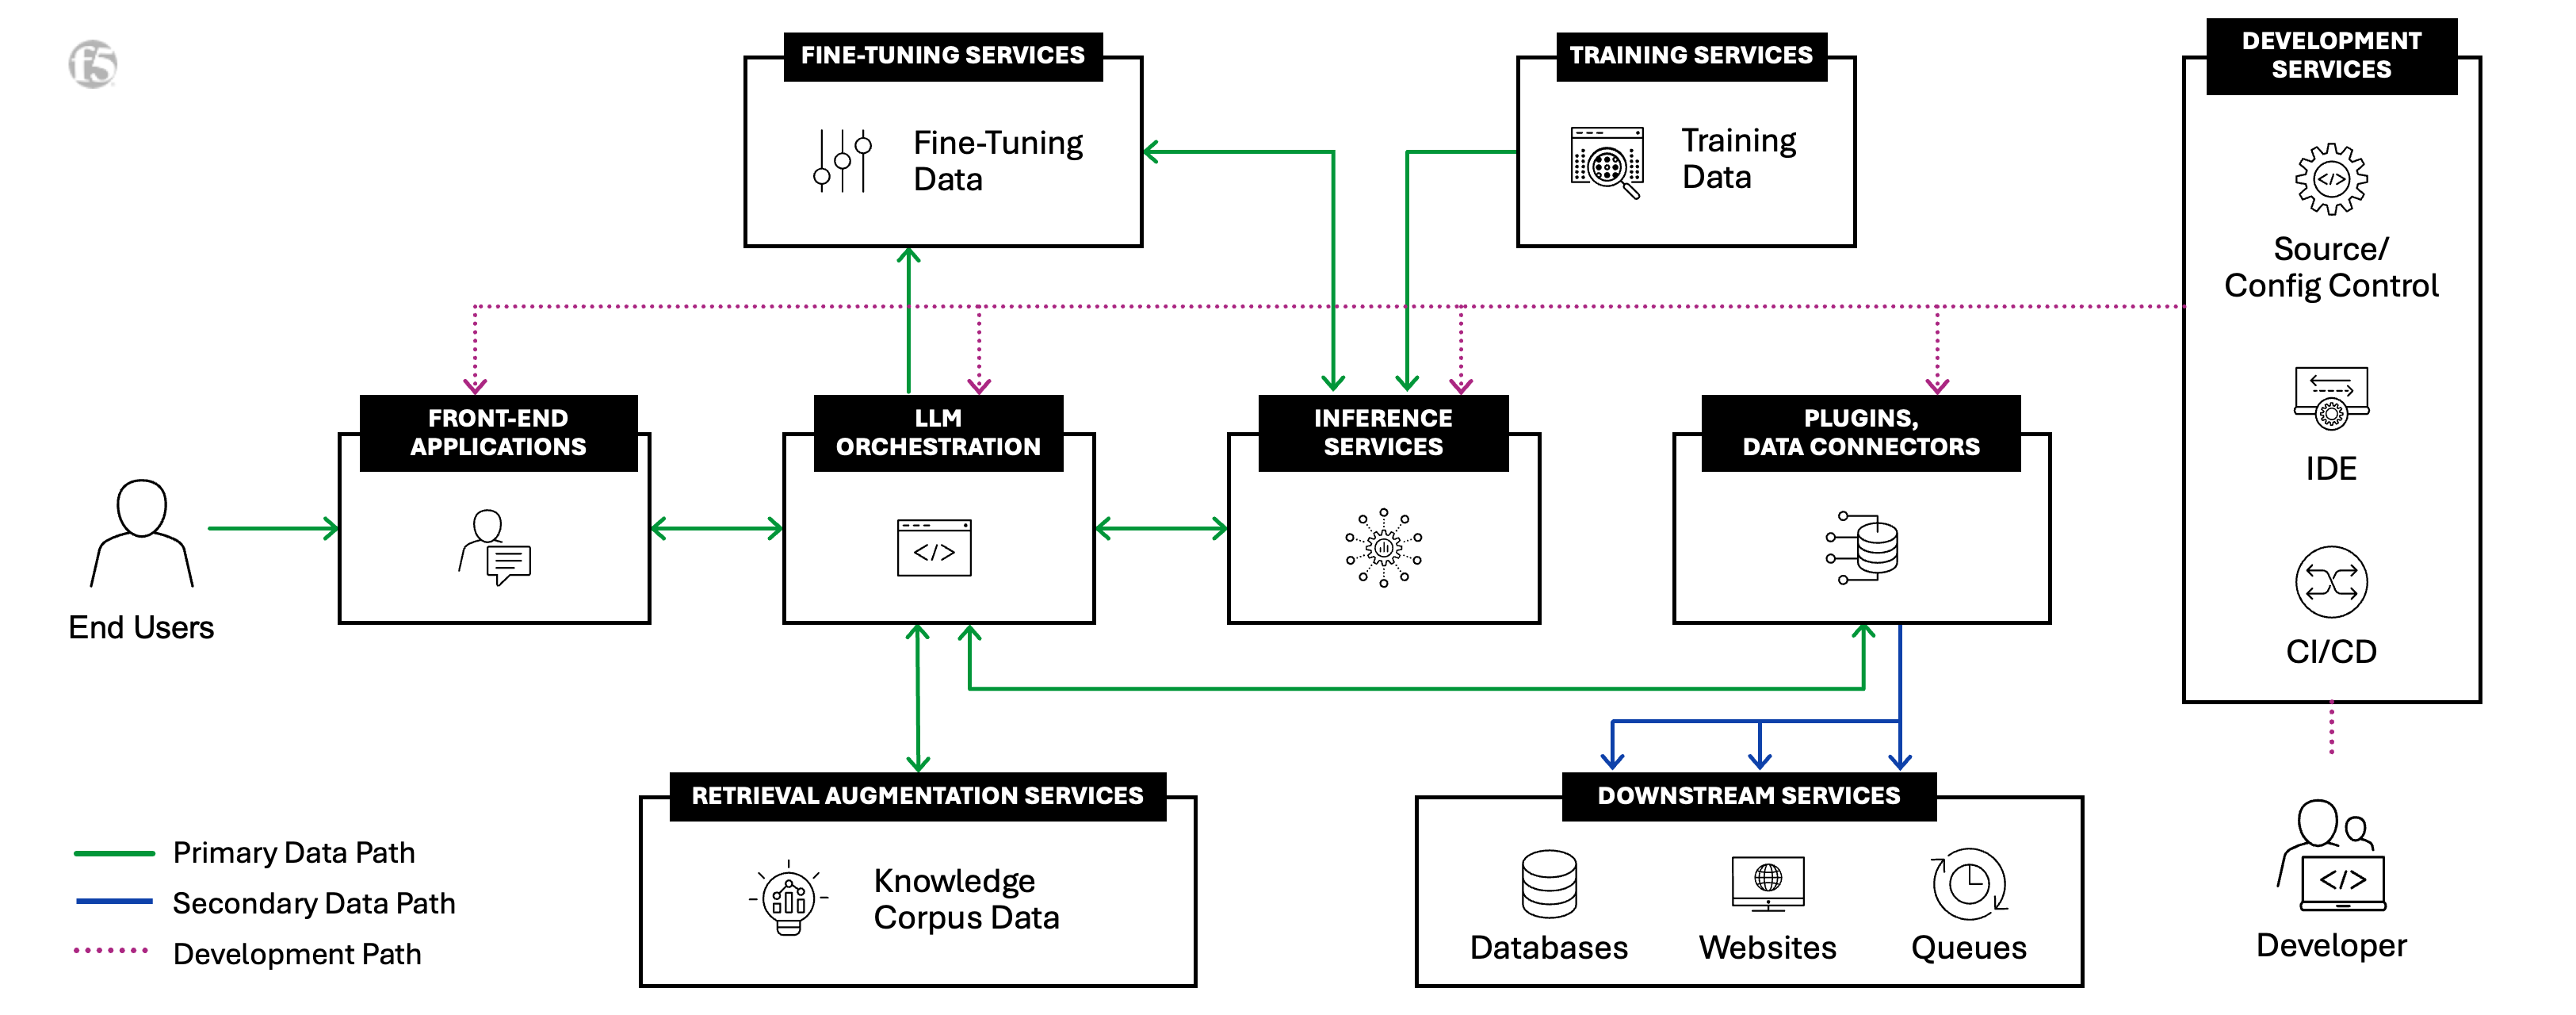
凭借帮助客户大规模部署高性能、安全的现代应用群的专业经验,F5开发了AI参考架构框架。AI应用处于现代应用发展的前沿,通过API广泛互联,且高度分布式。因此,该框架着力应对性能、安全和运营方面的关键挑战,这些挑战的解决对于交付前沿AI应用至关重要。
七大AI构建模块
在参考架构中,我们定义了构建全面的AI工厂所需的七大AI构建模块:
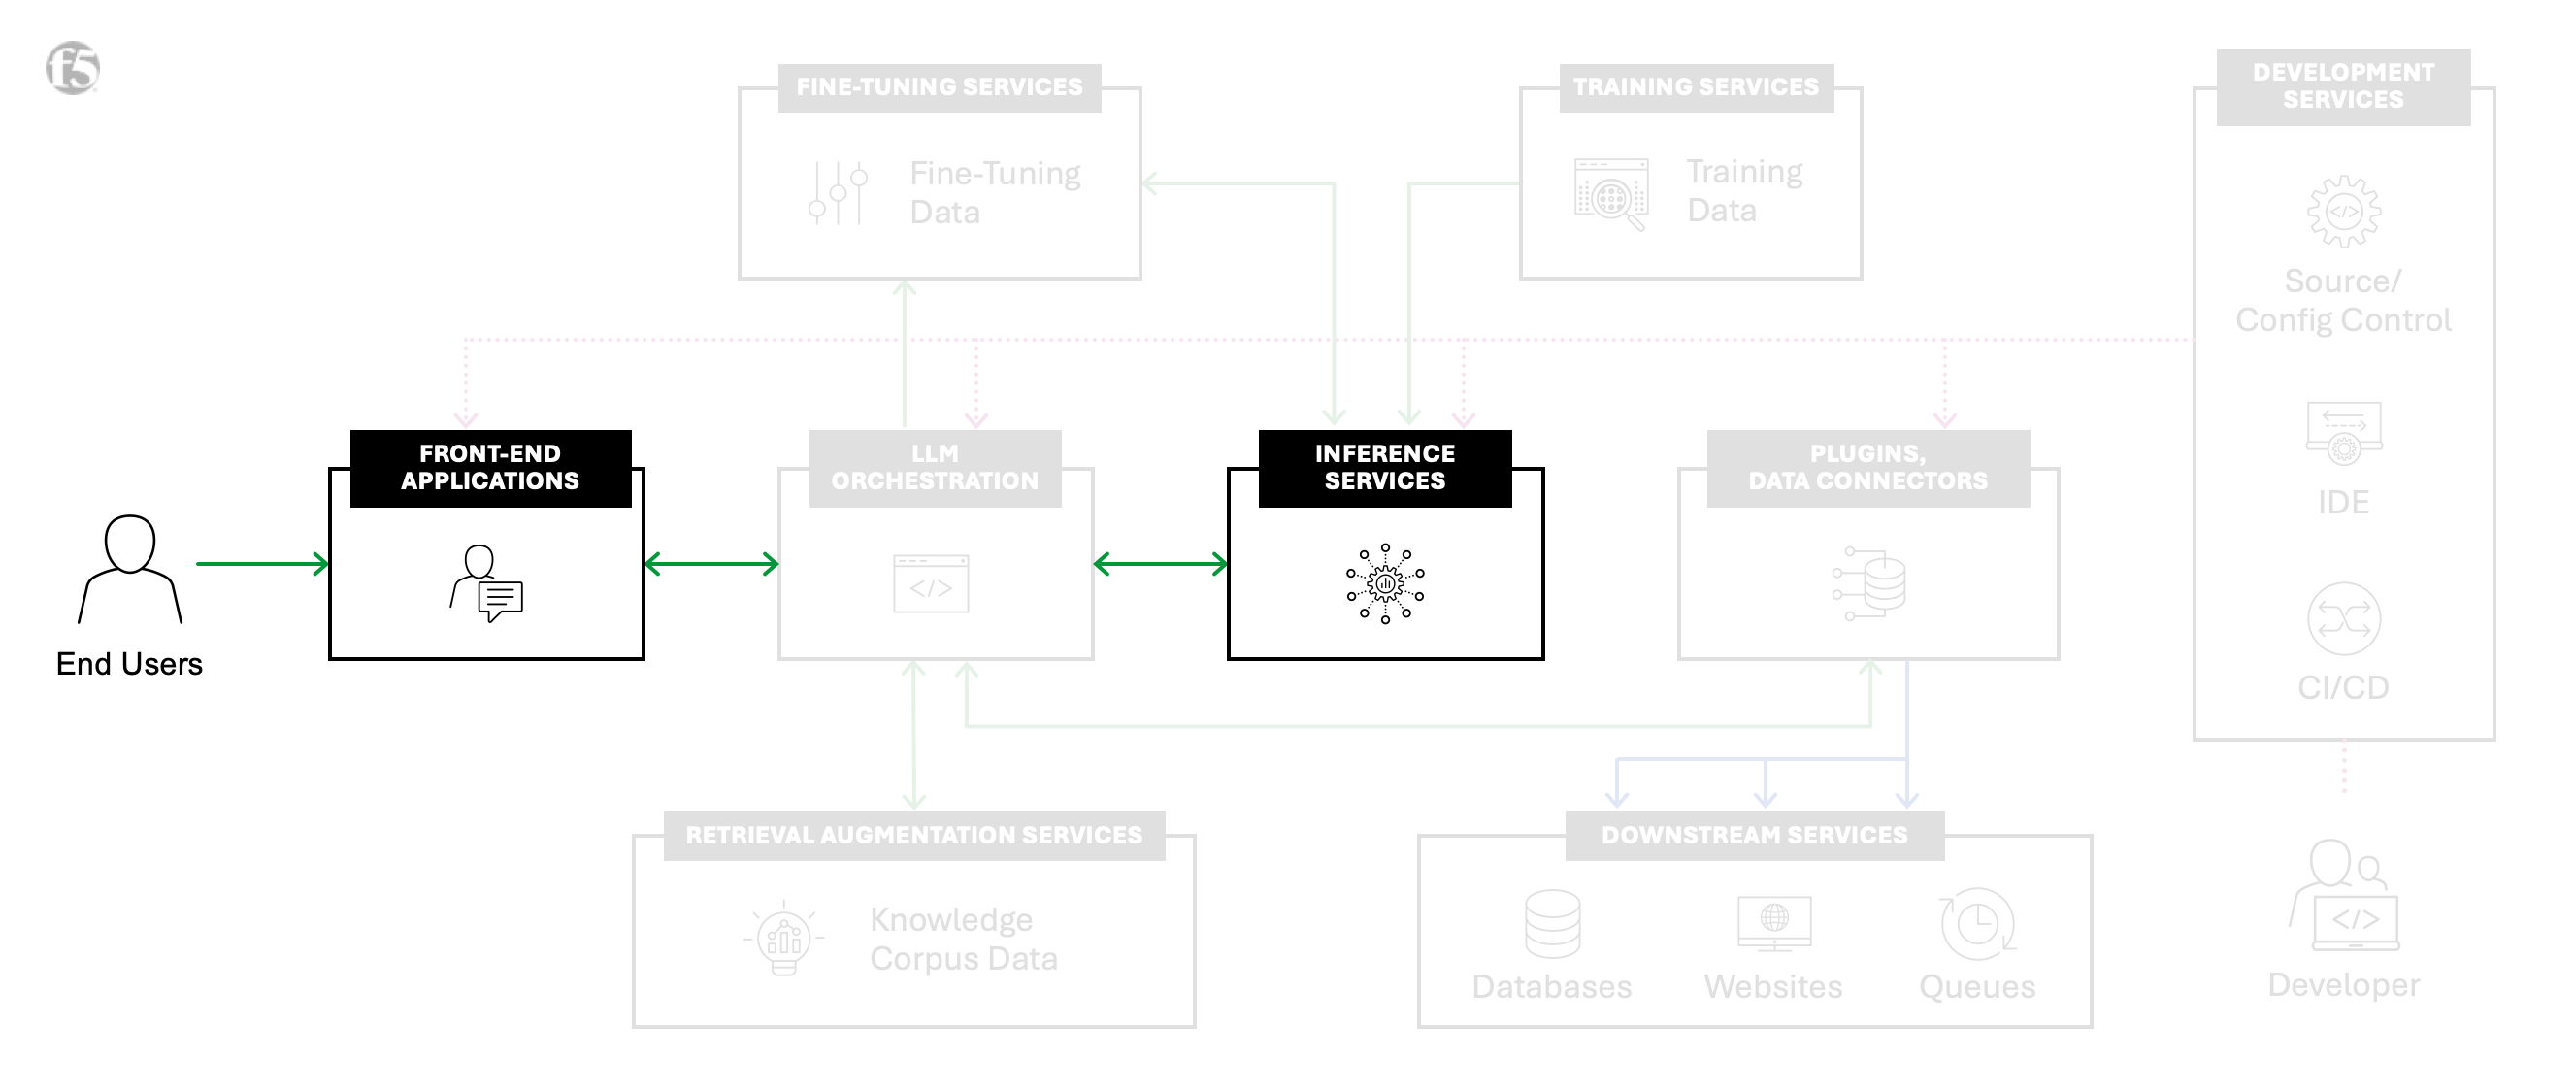
1. 推理
概述前端应用与推理服务API之间的交互,重点是向AI模型发送请求并接收响应。这为更复杂的交互奠定了基础。
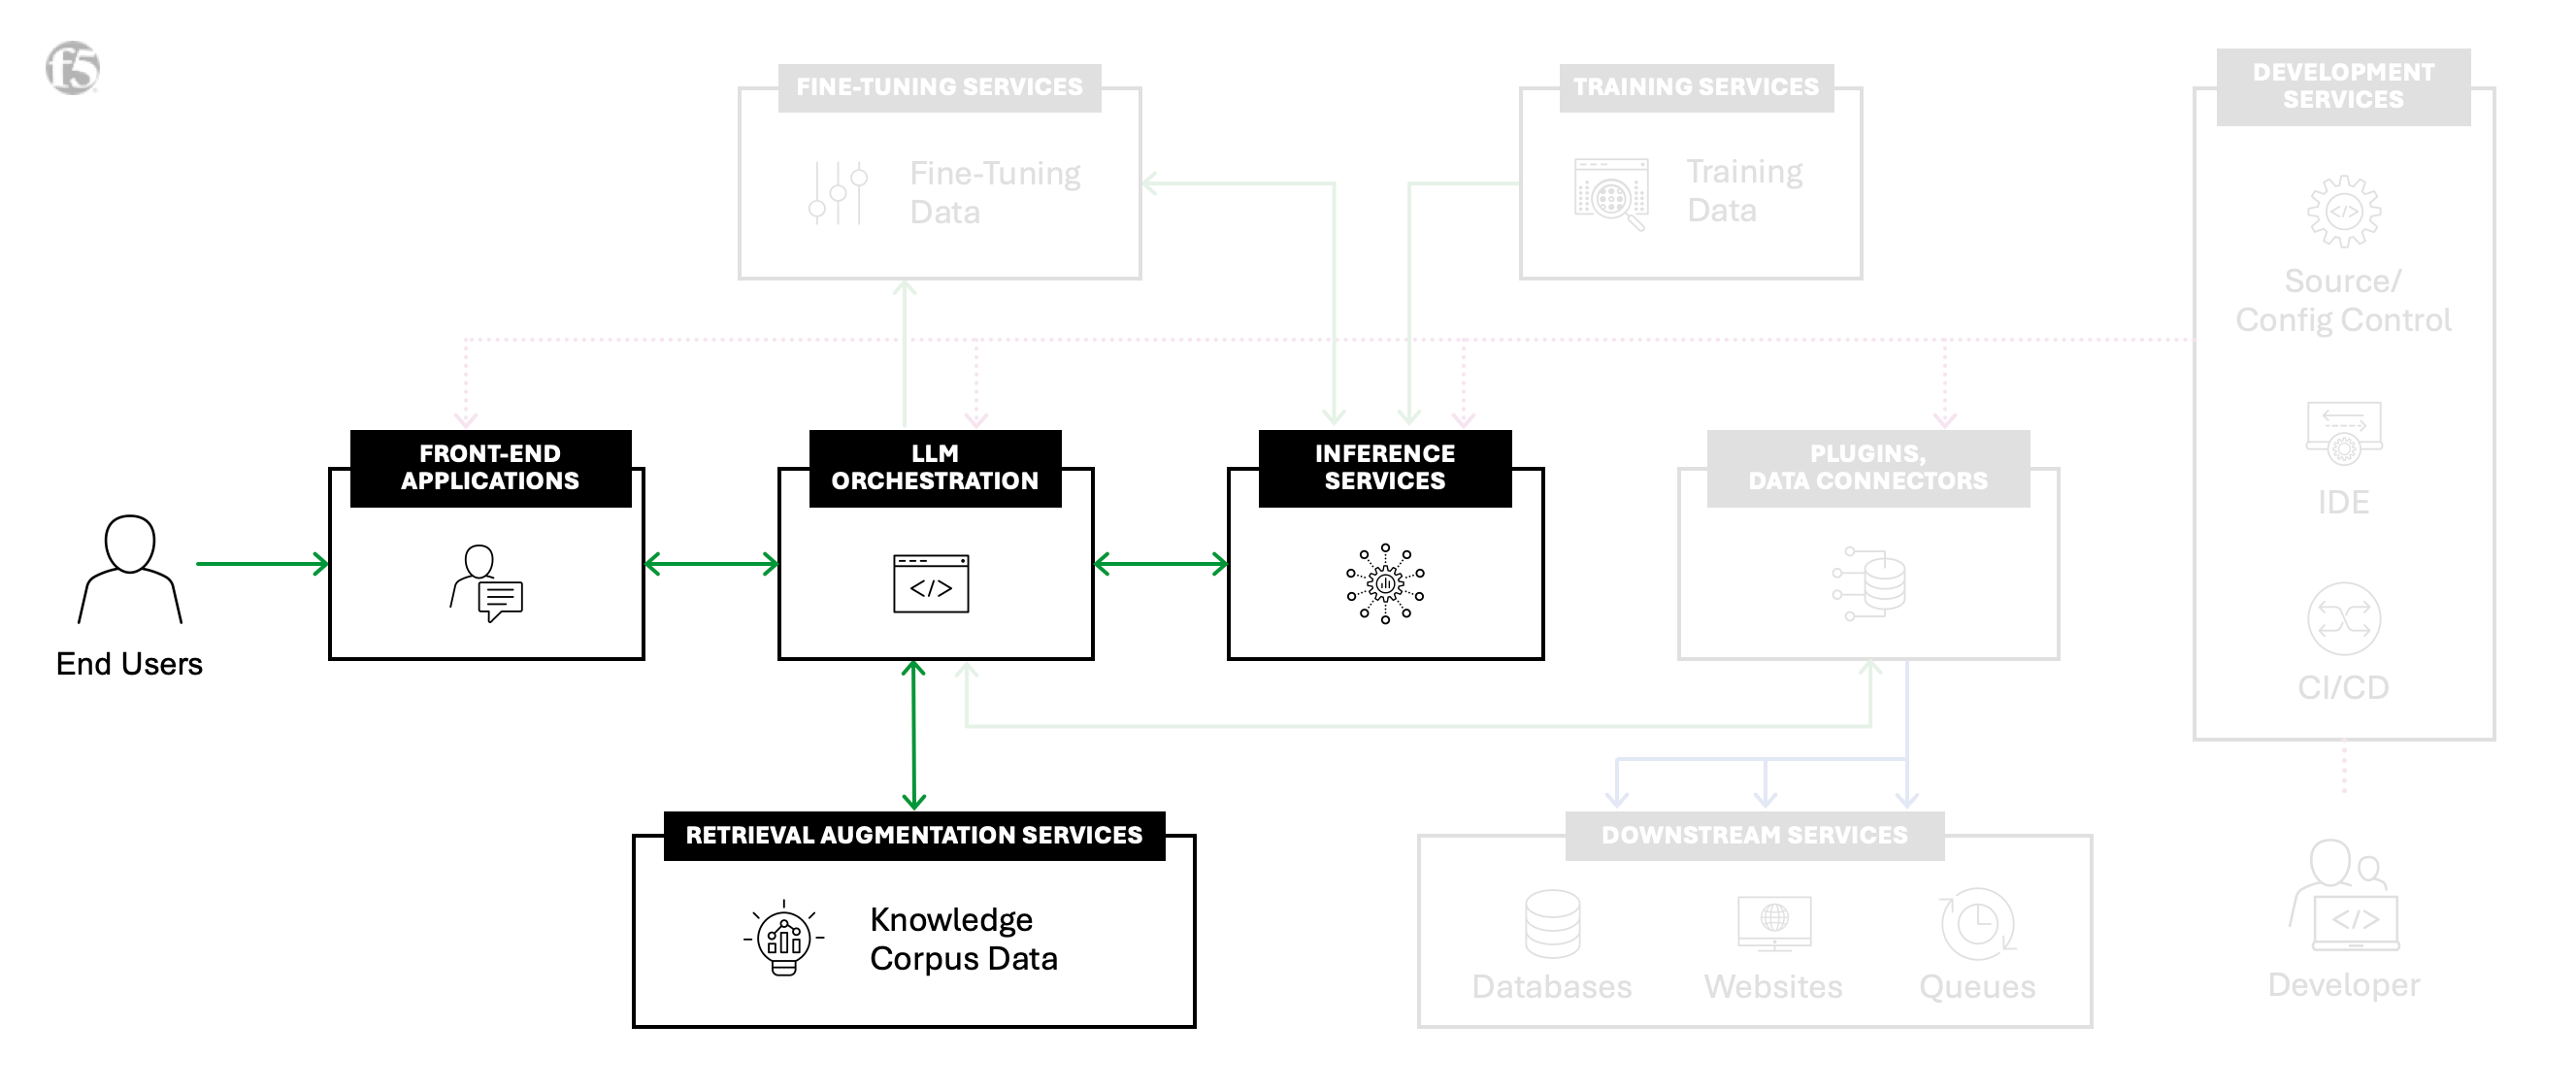
2. 检索增强生成
通过添加大语言模型(LLM)编排和检索增强服务,增强基础推理能力。具体介绍如何从向量数据库和内容存储库中检索补充上下文,再利用这些上下文生成包含更丰富上下文信息的响应。
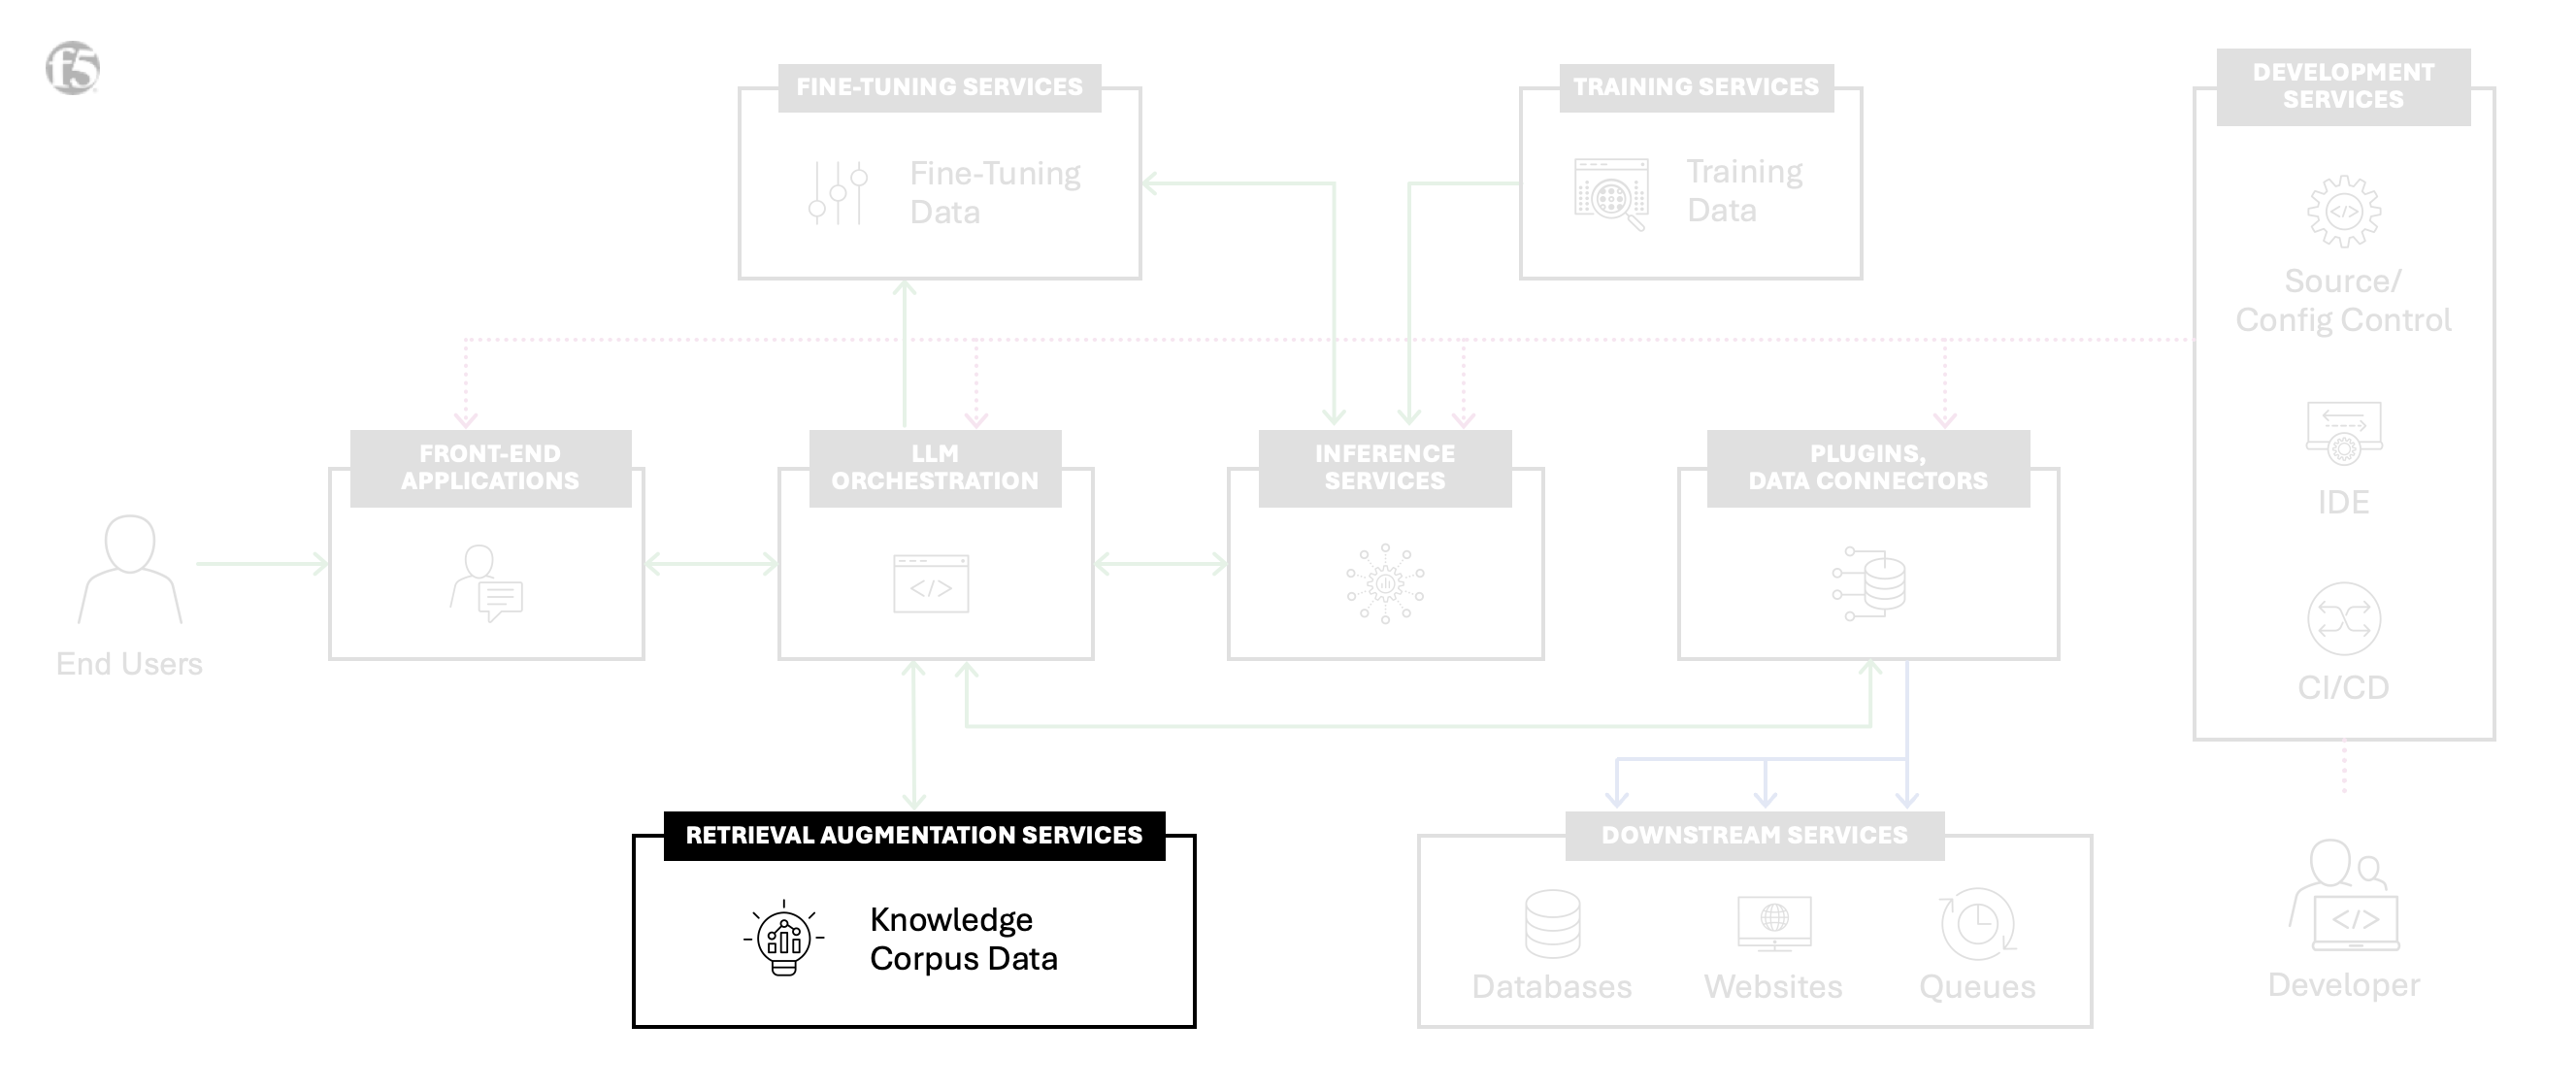
3. RAG语料库管理
重点介绍采用检索增强生成(RAG)进行推理所需的数据摄取流程,包括数据规范化、嵌入以及向向量数据库填充数据,为RAG调用准备内容。
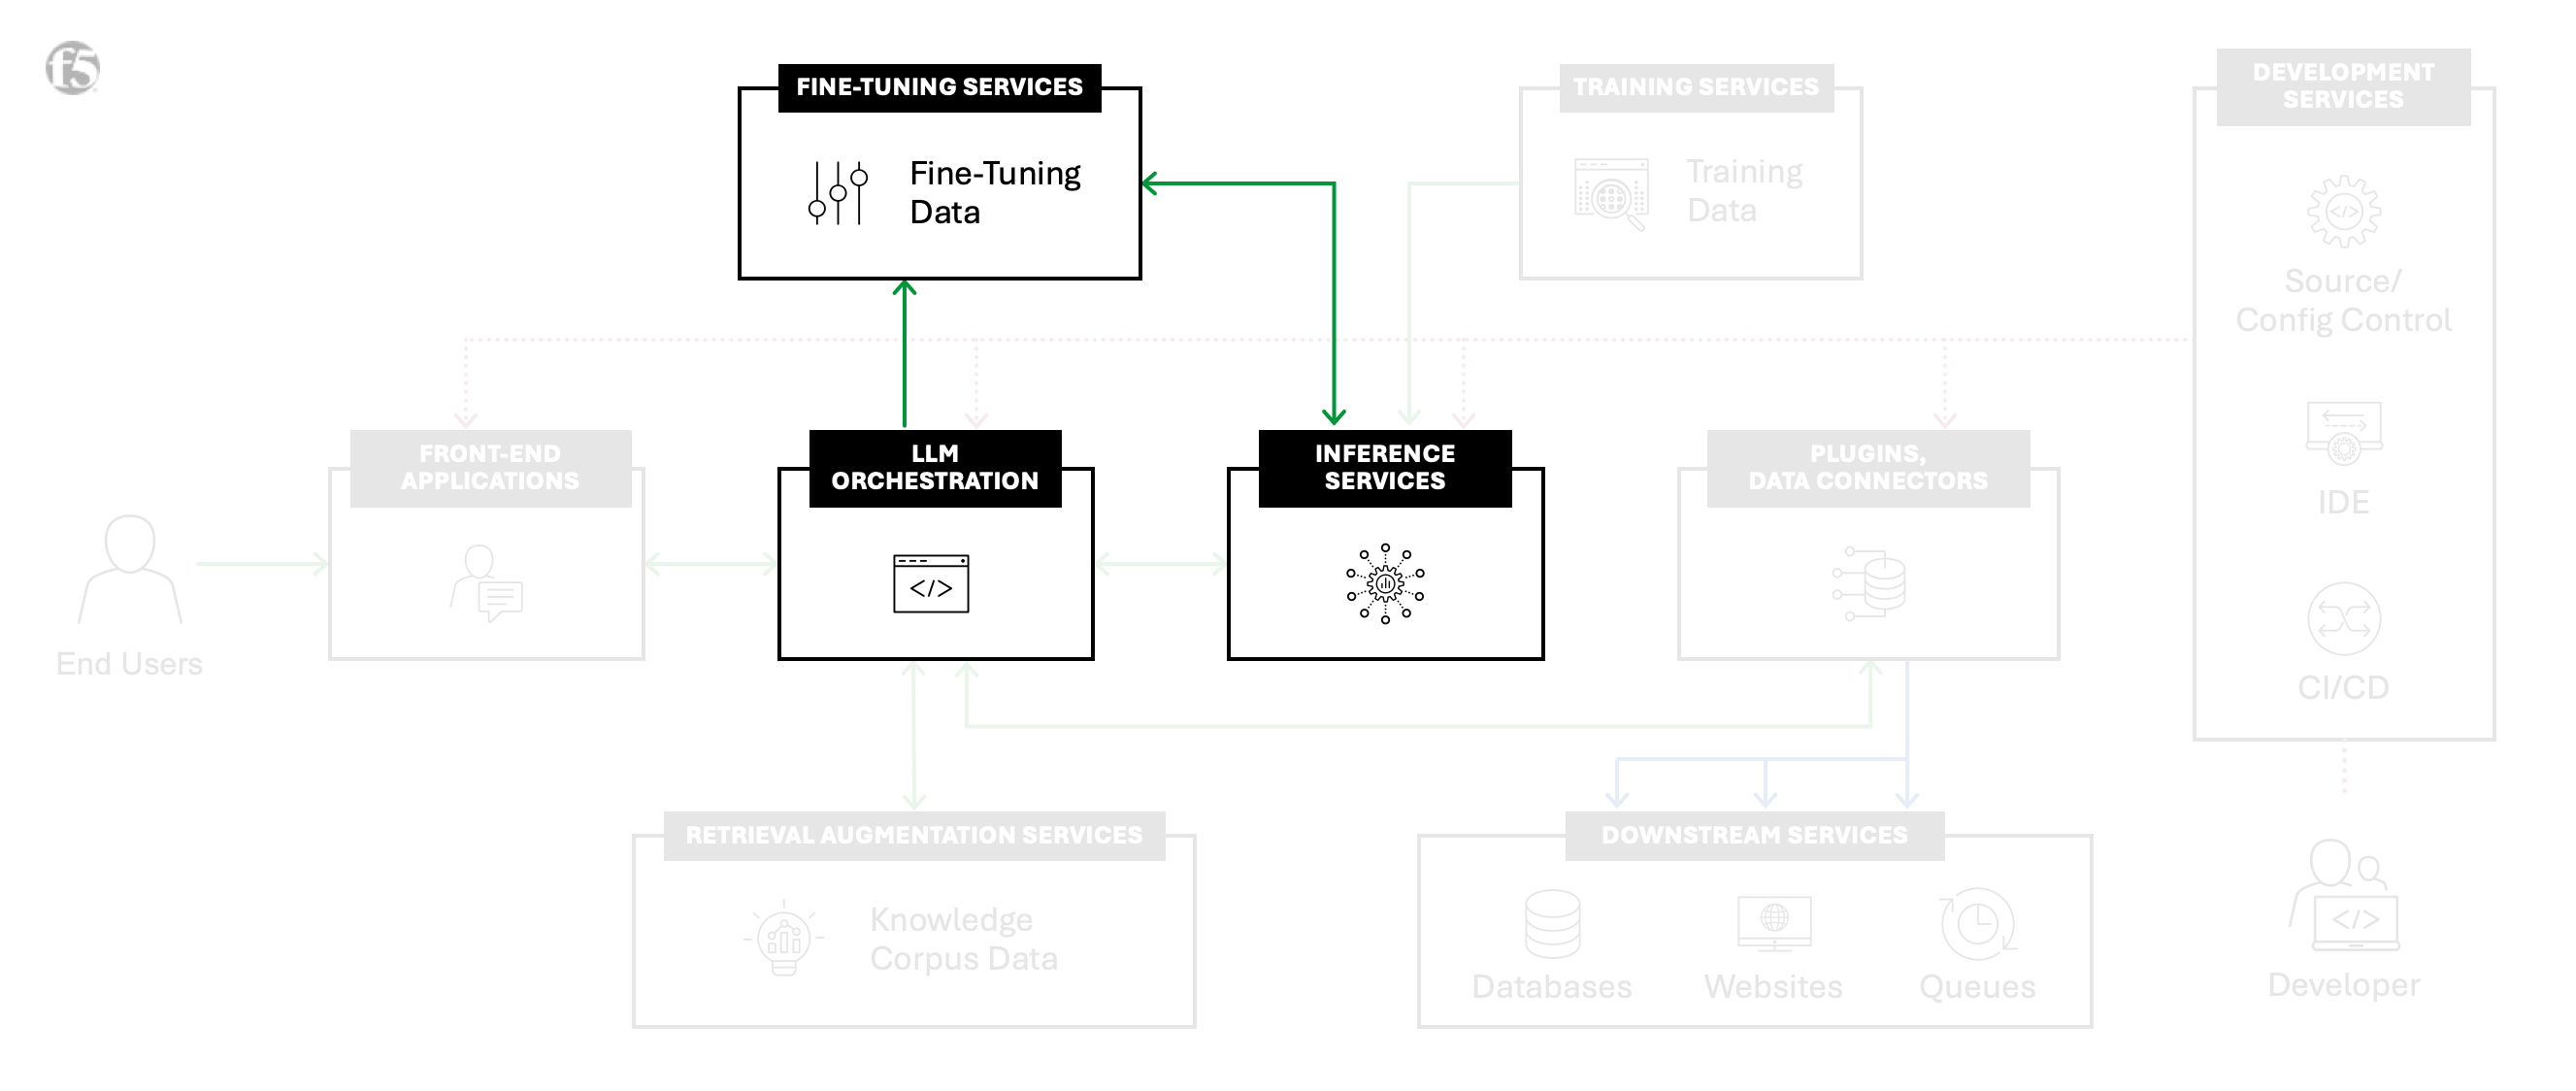
4. 微调
旨在通过与现有模型交互来提升其性能。微调无需从头重建模型,而是对其进行调整,并强调从推理和结合RAG的推理过程中收集数据,用于微调工作流。
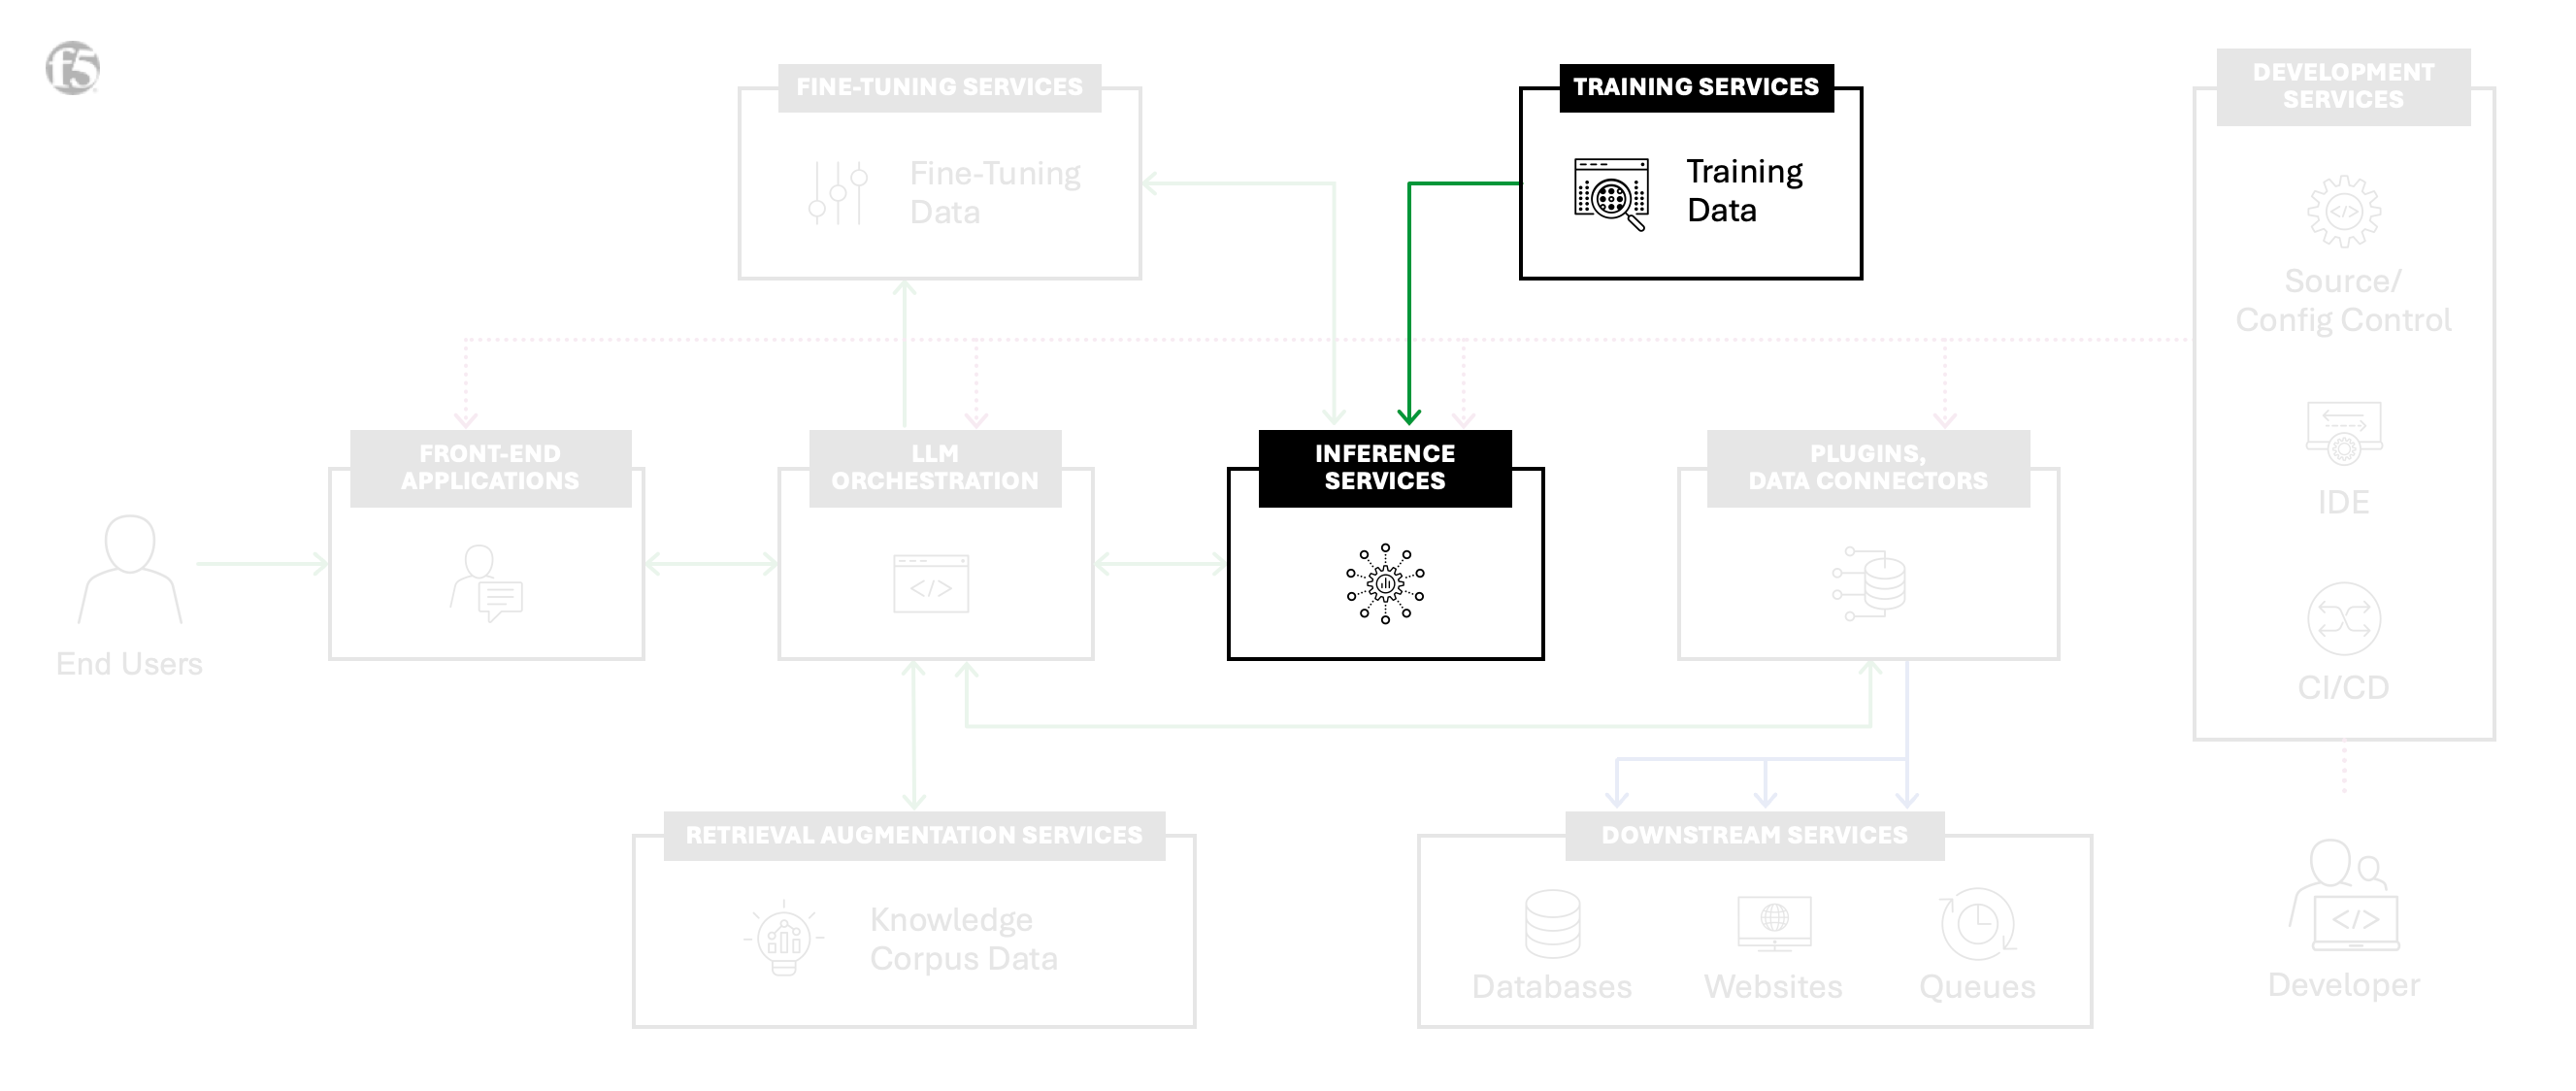
5. 训练
涉及从头构建新模型,但也可能使用先前的检查点(重新训练)。涵盖数据收集、预处理、模型选择、训练方法选择、训练以及验证和测试。这一迭代过程旨在创建针对特定任务的稳健模型。
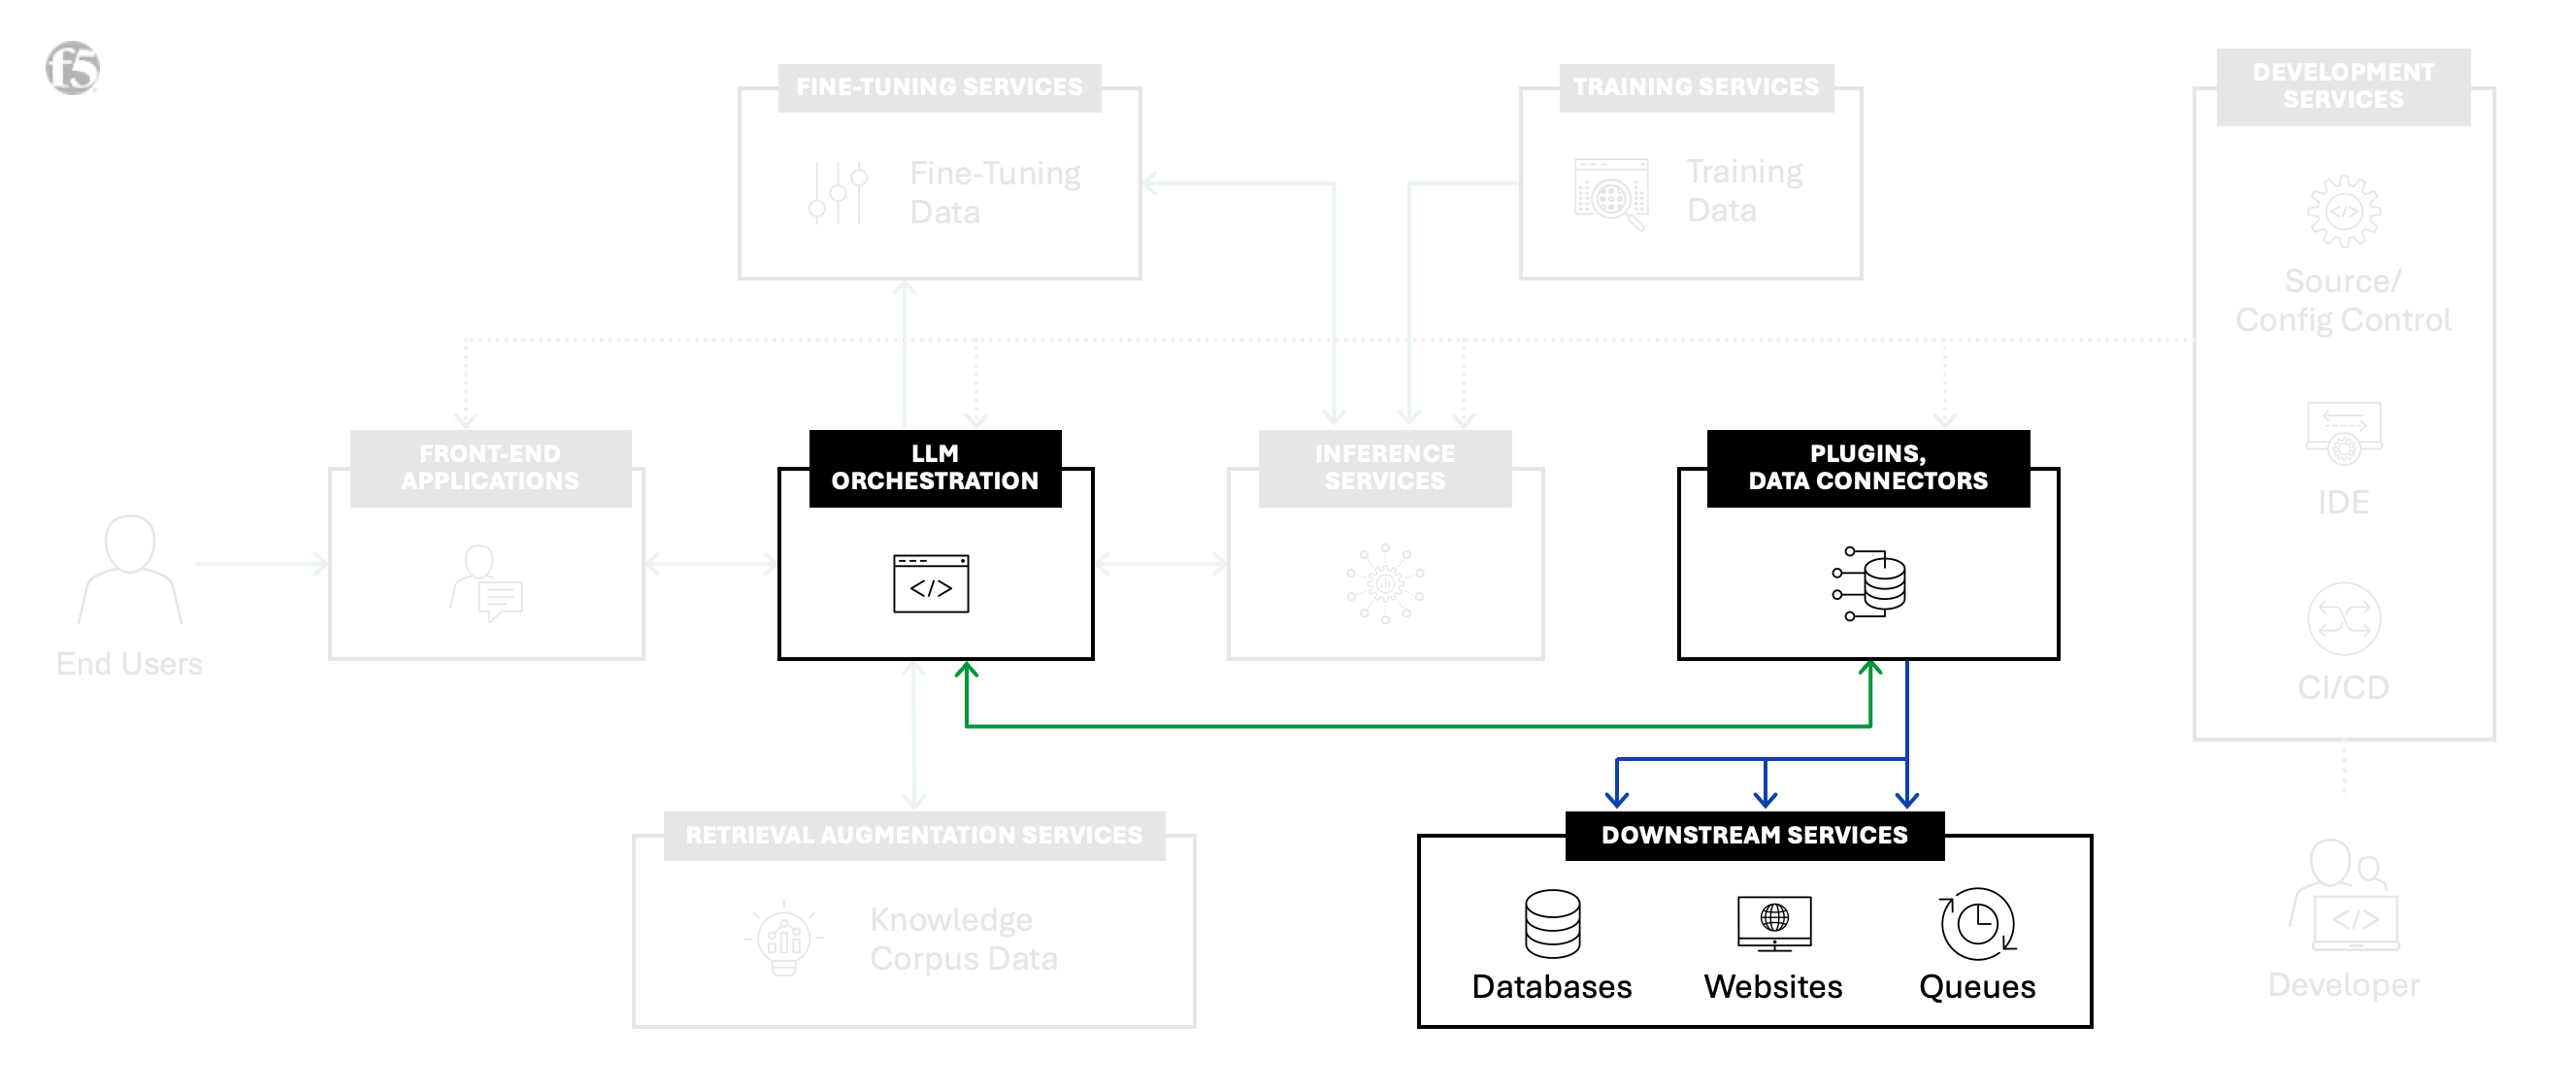
6. 外部服务集成
将LLM编排层连接到数据库、网站等外部来源。它将外部数据整合到推理请求中,但不包含分块和嵌入等文档预处理任务。
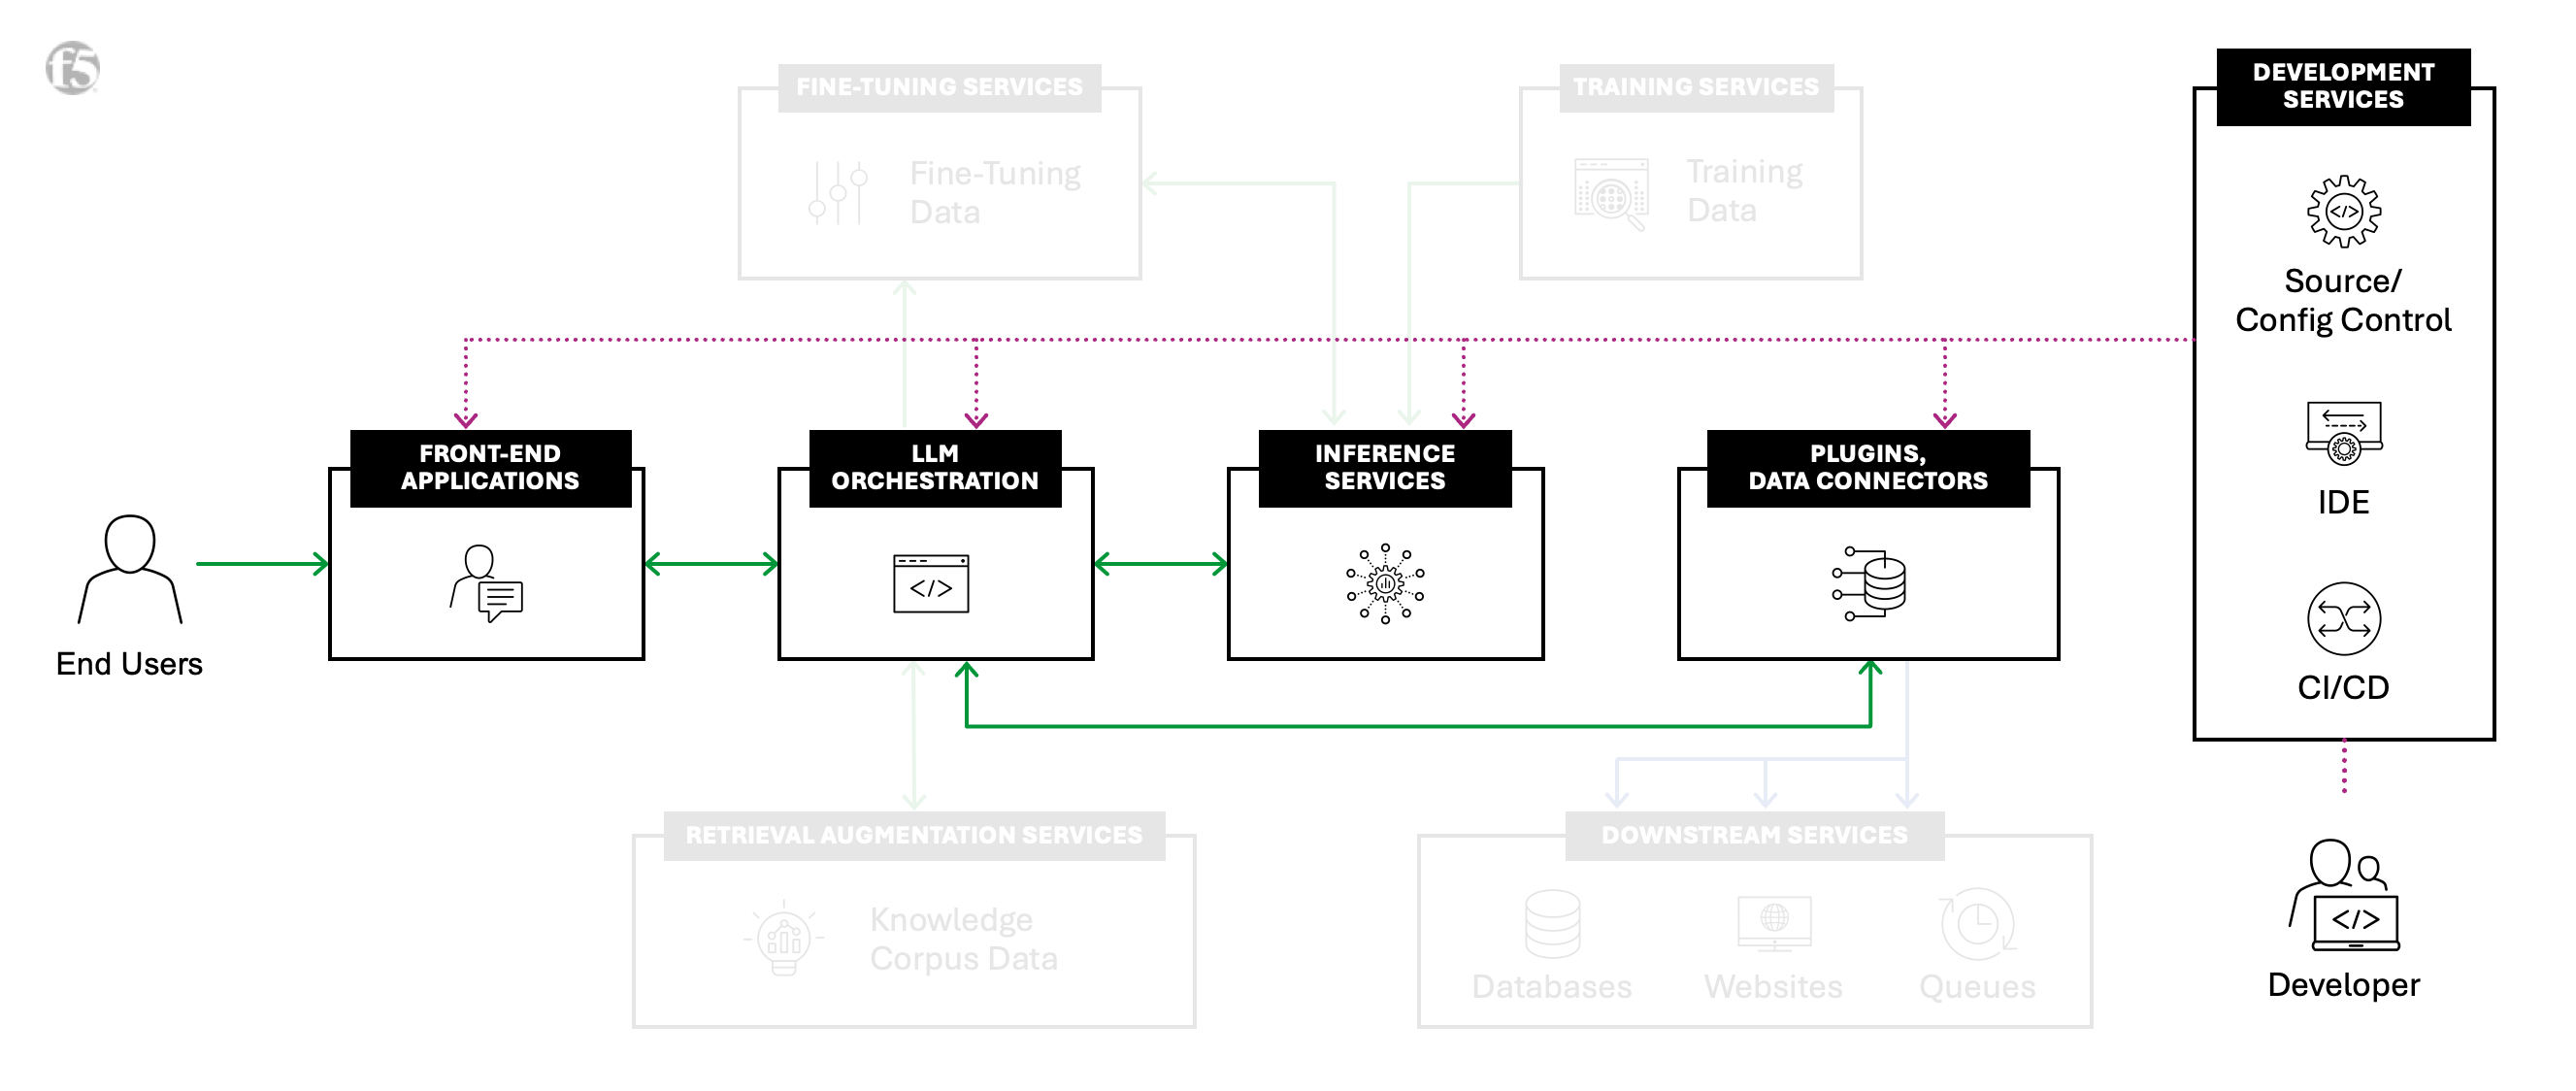
7. 开发
涵盖开发、维护、配置、测试和部署AI应用组件的工作流,包括前端应用、LLM编排、源代码管理和CI/CD流水线。
这些构建模块共同构成了AI工厂的骨干。每个模块都在AI输出的创建、部署和优化过程中发挥着关键作用。此外,AI工厂项目往往更倾向于自主掌控大多数构建模块的实施策略(而非租赁或外包),因此通常会在下列部署模型中选择自托管模式。
四种部署模式
对于每个构建模块,客户都必须选择合适的部署模型和实施策略(自有、租赁或外包),确定适合实现其AI项目业务目标的参考架构。以下是四种主要部署模型:
- AI-SaaS采用以软件即服务(SaaS)形式提供的推理服务,由服务提供商管理基础设施、模型更新和扩缩容。用户通过API与服务交互,无需操心底层维护。这种部署模式适合希望易于使用、快速集成且无需承担大量额外开销的企业,还支持快速扩缩容,并可获取最新功能和改进。
- 云托管部署是指利用云服务提供商(CSP)的基础设施即服务(IaaS)或平台即服务(PaaS)来管理推理服务。在此模式下,用户负责服务的配置、扩缩容和维护等管理工作,同时可利用CSP强大的基础设施和工具。此模式兼具灵活性和控制力,适合有特定需求且具备技术专长的组织。此外,此模式还支持与其他云原生服务和工具无缝集成。
- 自托管部署需要在自行管理的私有数据中心或主机托管服务中管理推理服务。这种模式提供高度的控制权和定制能力,使组织能够根据自身特定需求定制基础设施和服务。不过,维护、更新和扩缩容也需要投入大量资源。对于安全性、合规性或性能要求严格且云端解决方案无法满足这些要求的组织,通常会选择这种模式。
- 边缘托管部署是指在边缘环境中运行AI或机器学习(ML)服务,例如零售自助终端、物联网设备或其他本地环境。这种模式在靠近数据源的位置处理数据,从而降低延迟,非常适合实时应用以及互联网连接受限或不稳定的场景。它需要可靠的本地硬件和软件管理,但对于需要即时、本地化决策的用例,能够带来显著收益。边缘托管部署在零售、制造和医疗等行业尤其有价值。
F5在任何位置交付并保护AI应用
日常应用交付和安全所依赖的F5能力,同样也是构建精心设计的AI工厂的关键。F5 BIG-IP Local Traffic Manager搭配F5 rSeries和VELOS专用硬件,可为AI训练提供高性能数据摄取能力。F5 Distributed Cloud Network Connect提供安全的多云网络连接,将分散的数据位置连接起来,在专有数据与AI模型之间建立安全通道,以支持RAG。
F5对AI的关注不止于此,了解F5如何在各种环境中保护和交付AI应用。
想进一步了解AI工厂?欢迎阅读AI工厂系列博客中的其他文章:
- 面向AI工厂的检索增强生成(RAG)›
- 优化AI工厂数据摄取的流量管理 ›
- 优化边缘数据源与AI工厂的连接 ›
- 多云可扩展性和灵活性为AI工厂提供支持 ›
- NVIDIA BlueField DPU对AI工厂的作用与意义 ›
- 面向AI工厂的API保护:迈向AI安全的第一步 ›
- 网络分段对AI工厂的重要性 ›
- AI工厂打造前沿的现代应用:AI应用 ›
关于作者
Hunter Smit是F5解决方案与战略产品营销高级经理。他负责F5产品组合的解决方案营销工作,涵盖AI基础设施和应用安全,并推动F5进军新兴的AI数据交付市场。Hunter是Whitworth University商学院顾问委员会成员,并曾担任产品营销兼职讲师。他拥有Whitworth University工商管理硕士学位和管理学工商管理学士学位。
Hunter Smit 的更多博客文章相关博客文章

Thingbot正转变为攻击平台
Lori MacVittie重点介绍了F5 Labs对2018年1月至6月全球物联网设备攻击的研究,并指出了其中令人警醒的影响。物联网设备不仅持续遭到利用,还被转变为攻击平台,这意味着攻击者可以更充分地利用这个必然增长的市场。
借助F5全新Quick Start,在AWS上快速开展业务
在AWS re:Invent开幕前,我们很高兴与大家分享F5与AWS之间全新的Quick Start集成。F5的Tom Atkins将介绍该服务如何启动、配置和运行在AWS上部署工作负载所需的计算、网络、存储及其他AWS服务。