多年来,网络分段一直是实现威胁隔离、差异化服务质量、事件响应与分析、合规审计以及其他诸多关键互操作功能的核心。然而,当我们推崇零信任原则、急于部署AI时,是否忽视了网络基础设施的这一核心要素,而它正是现代网络安全与服务运营的基石?
在此前的AI工厂系列文章中,我们将AI工厂定义为一项大规模的存储、网络和计算投资,用于满足大规模、高性能训练和推理需求。为实现这项投资的回报,AI工厂会动态调度高价值的图形处理器(GPU)和计算资源,以执行这些训练和推理任务。调度GPU需要在每个AI集群中为AI服务构建多个“租户”。这带来了一个问题,许多运维团队往往未能提前察觉,等到发现时,常常为时已晚。
使AI工厂集群资源与网络分段相匹配
在AI集群内,我们可以根据租户上下文对资源进行逻辑分段,从而实现租户配额、资源消耗限制、主机系统安全以及基于角色的管理访问控制(RBAC)。然而,为AI集群与AI工厂网络其余部分之间的流量提供出入口的基础网络服务,并未暴露租户上下文。缺少这些上下文,作为数据中心网络安全基石的网络分段便无法感知租户信息。用于暴露必要租户上下文的常见方法,要么大量占用AI工厂的高价值算力,要么降低网络路径性能,导致服务时延、带宽或并发能力无法满足要求。我们因此陷入一种看似必须二选一的困境:要么高效利用AI工厂的高价值资源,要么实现租户与网络的合理集成。
在公有云基础设施中,经过编排的多租户网络设计是云区域内所有服务的基础,并通过虚拟私有云(VPC)实现。这种虚拟化网络分段对安全和资源计量至关重要。公有云提供商依靠网络软件开发团队以及包括SmartNIC和数据处理单元(DPU)在内的专用网络硬件来维持这一功能。公有云中的AI工厂集群旨在利用底层基础设施的VPC网络编排能力。维护VPC的成本相当高,但这项功能是公有云业务模式的核心。
问题随之而来:组织如何在无需达到公有云提供商同等投入水平的情况下,充分发挥AI工厂投资的价值,并动态调度GPU和计算资源?
行业在这一进程中的第一步,是利用服务器虚拟化创建虚拟机(VM)。虚拟机通过硬件直通连接到分段的数据中心网络。如果只涉及单个AI集群中的单个租户,只需将所有虚拟机置于相同的VLAN中,即可照常运行。
虚拟机也可用于GPU分区,因为GPU供应商支持将GPU设备细分为多组核心和内存,再分配给特定虚拟机。不过,GPU设备分区无法动态进行,需要重启虚拟机。此外,这种设计限制了构建可对多个租户的使用量进行计量的GPU资源池的能力。这些都是该方案的显著不足。
使网络分段与多租户AI工厂集群相匹配
当AI工厂集群不再仅为单个租户提供服务时,会发生什么?问题会转移到数据中心。在AI工厂集群中,默认情况下,所有流出集群并进入数据中心的网络流量都会经过源网络地址转换(SNAT),其源IP地址会被转换为发起网络请求的容器化工作负载所在集群节点的IP地址,从而掩盖真实来源。随后,这些流量便以该节点所部署的网段为来源。对于多租户集群,这意味着租户上下文丢失,多个租户的出站流量混杂在一起,无法区分来源,也无法实施安全防护、故障排查或审计。
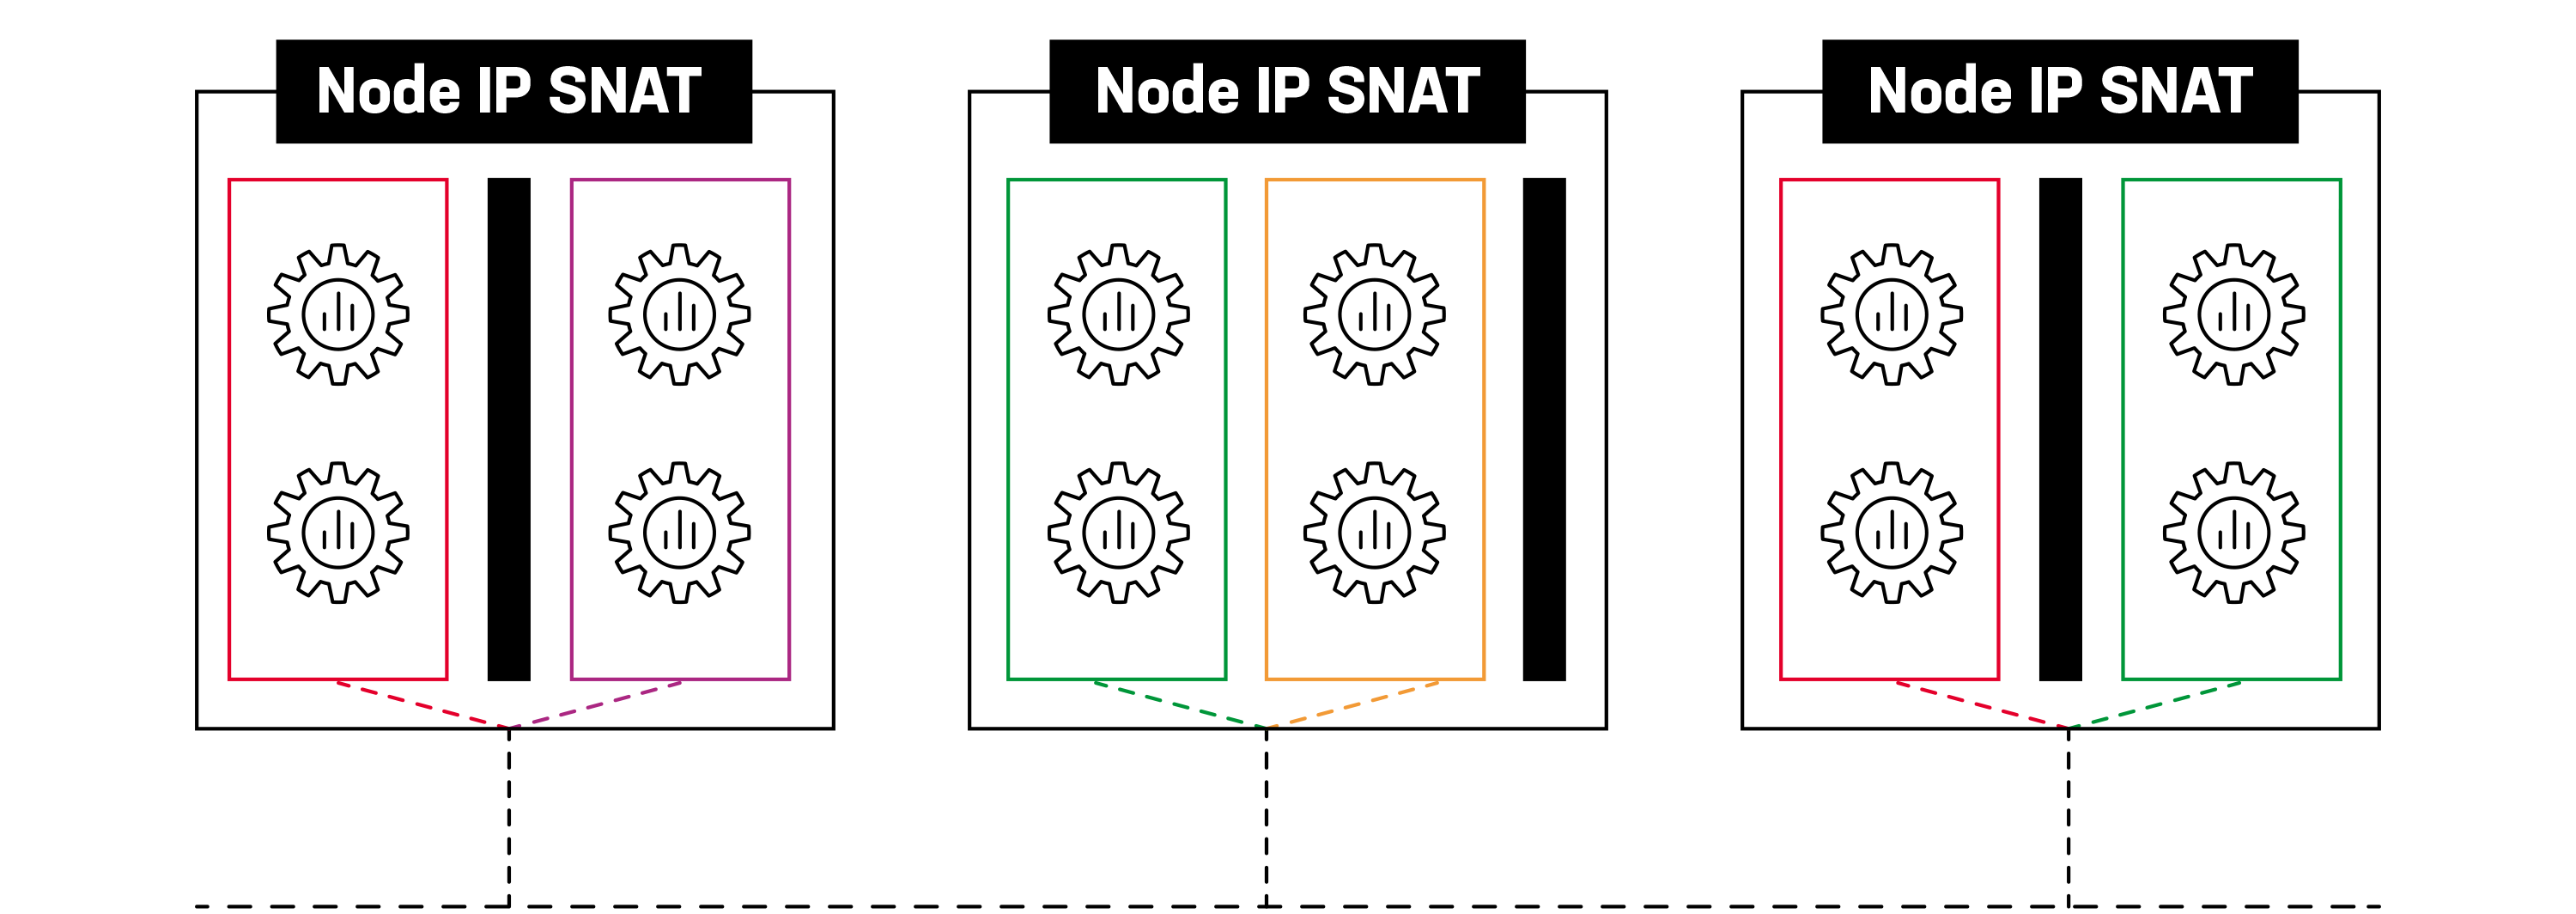
默认情况下,出站流量中的集群租户上下文会丢失。
纳入入站流量后,这一问题会更加突出。入站流量来自已完成分段的数据中心,因此可能更易于管理,但如何将单个租户的入站流量与其出站流量关联起来?答案与检索增强生成(RAG)和智能体服务密切相关,这些服务会进行大量通信,以获取外部数据并使用外部服务。因此,无论是为客户排查问题,还是为通过安全审计而开展工作,都需要平台工程师与网络运维团队跨团队协作。
企业可能会问:“为什么不能直接使用软件定义网络(SDN)叠加技术,像超大规模云服务提供商那样构建VPC网络呢?”这当然可行,但成本会转移到维护现有数据中心基础设施之上的SDN VPC网络上。如果需要二层(例如VxLAN)分段,难点就变成了如何通过机架顶部交换机编排隧道,以及如何配置这些交换机以匹配网络分段。这正是超大规模云服务提供商选择SmartNIC并转向主机到主机级别编排的原因,让数据中心网络保持高速,而无需具备智能处理能力。
大多数组织缺乏网络编程人才,或不愿自行负责如此复杂的主机级编排,又或者根本无法放弃保障服务质量所需的骨干网络可见性。针对这些问题提出的第3层(例如IP)路由解决方案,使网络团队走上了这样一条路:将每个AI集群节点都配置为数据中心的动态路由(BGP)对等体,并试图通过多个路由反射器提供基本的IP子网租户隔离。这同样使运维人员面临极其复杂的路由问题和安全审计,并且已经导致过整个区域的服务中断。
面向AI工厂的集群感知型编排式网络分段
AI工厂必须规划采用网络功能丰富、可编程、安全且低延迟的解决方案,并支持带宽和并发能力扩展。必须将集群内部的第2层(例如VLAN、VxLAN)和第3层(例如子网、IPSEC接口)租户上下文呈现到AI工厂网络中。必须为NetOps提供可观测性指标、日志和调试工具。
传统上,这类应用租户管理和可见性解决方案大多由F5 BIG-IP提供。F5 BIG-IP Container Ingress Services (CIS)可动态发现Kubernetes服务,并以虚拟服务器的形式将其暴露给数据中心。BIG-IP管理员在配置物理服务器和虚拟机的对外呈现方式时,已熟悉虚拟服务器这一配置对象。虽然BIG-IP确实满足了我们对解决方案的许多要求,但它并不管理从AI集群流向AI工厂网络的出站流量,而这种管理是维持网络分段所必需的。
为解决这一问题,我们设计了F5 BIG-IP Next for Kubernetes,这是一款基于我们的下一代平台BIG-IP Next构建的多租户计算集群解决方案。
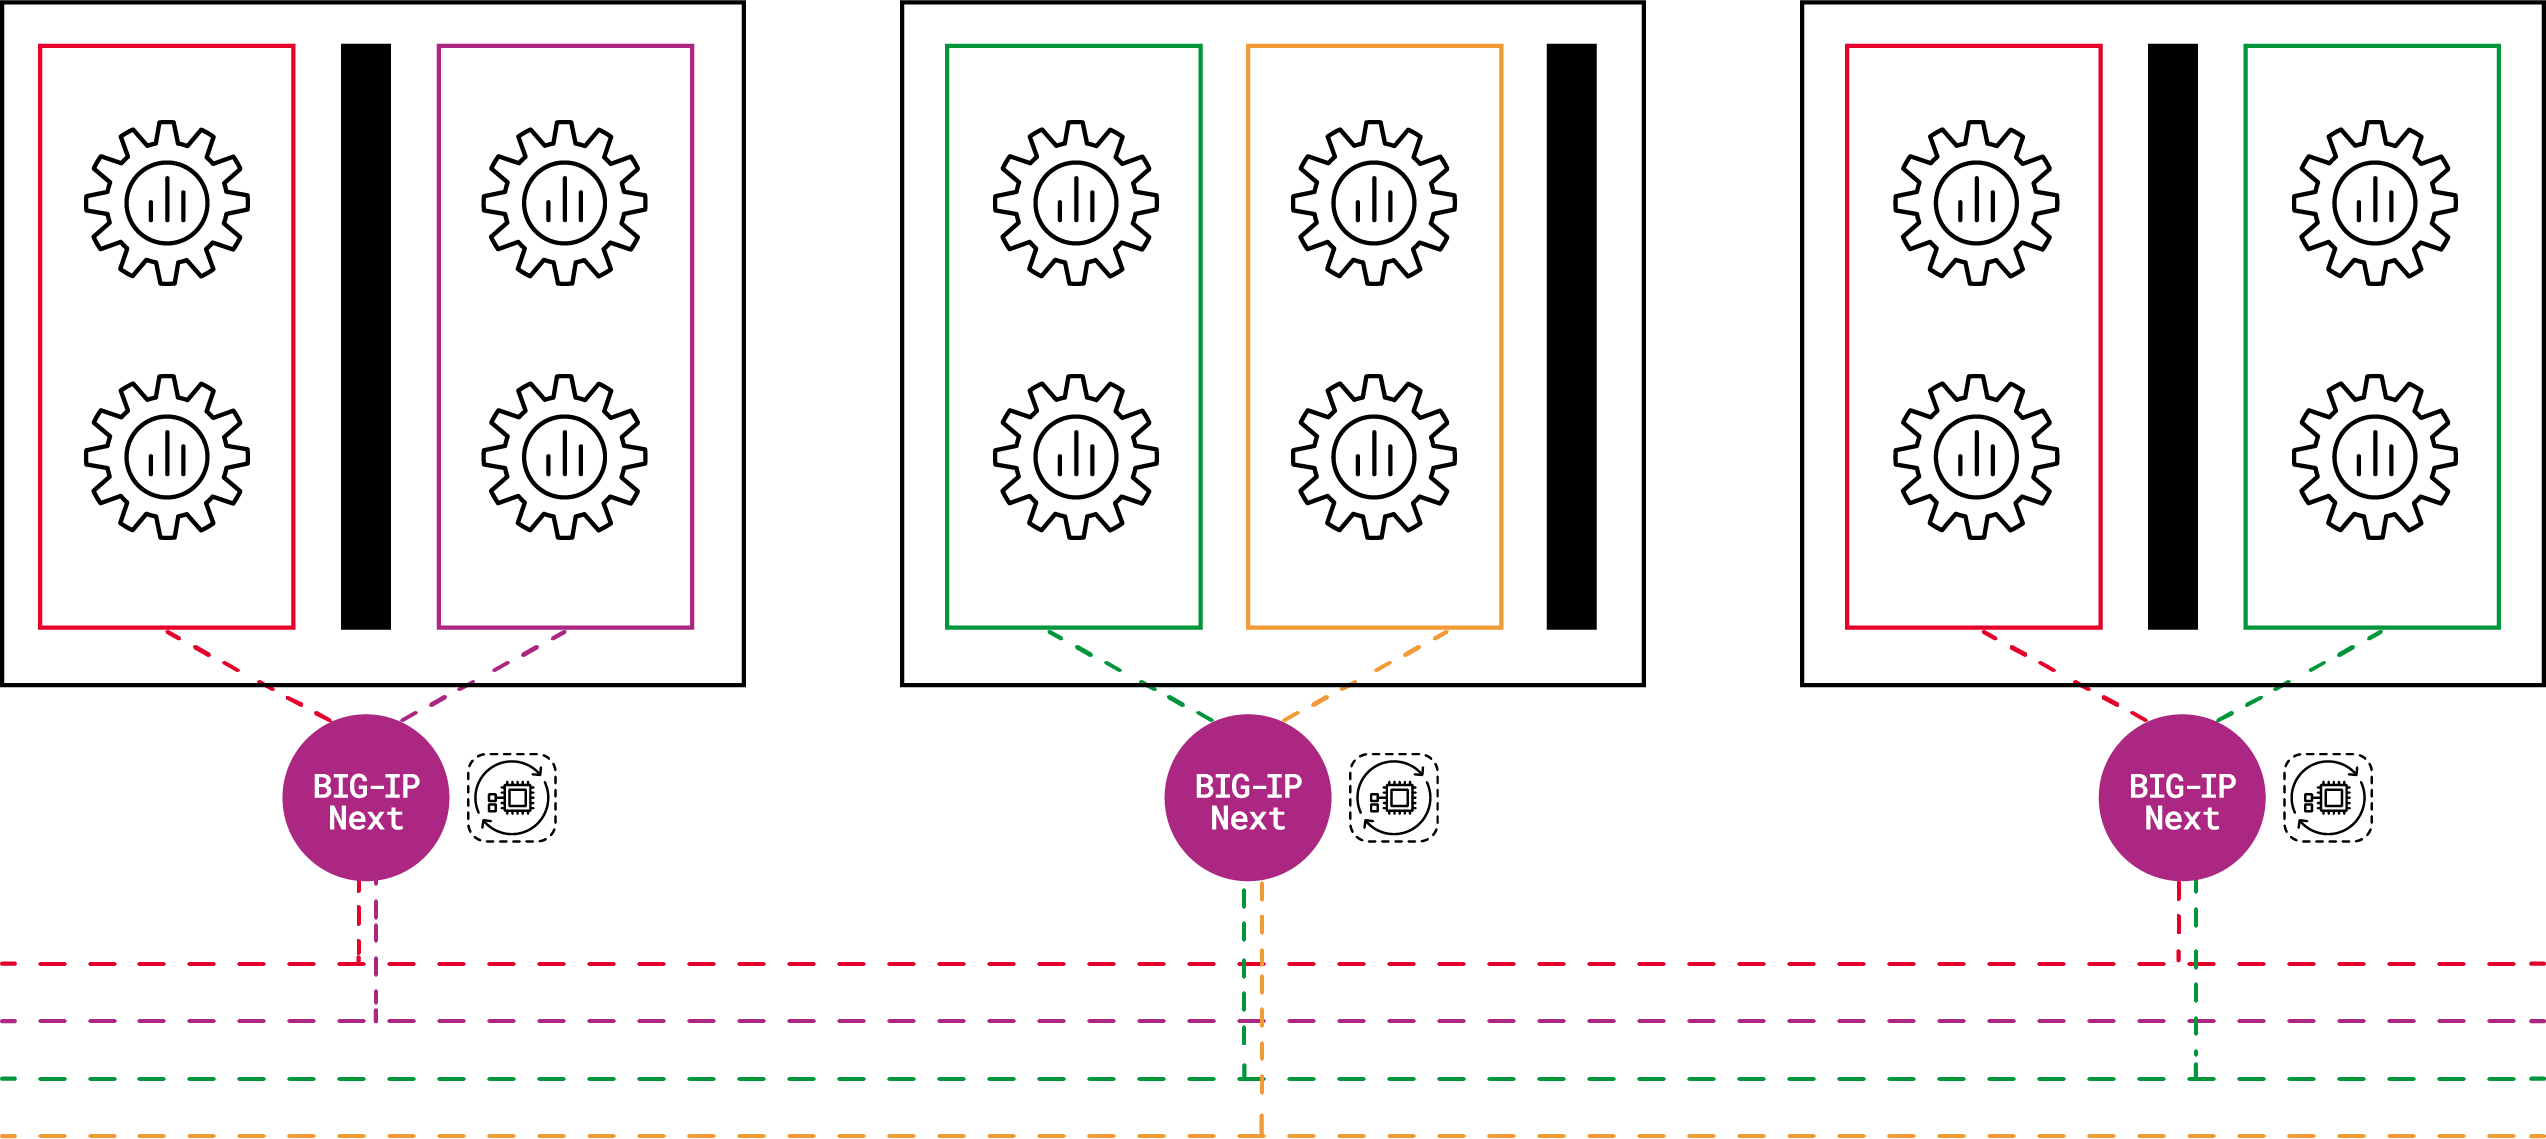
BIG-IP Next for Kubernetes使NetOps能够将集群租户与网段关联。
BIG-IP Next for Kubernetes完全通过Kubernetes控制平面进行管理,支持Kubernetes管理身份验证以及针对所有已声明资源的RBAC,并通过命名空间识别Kubernetes租户,以支持入站和出站流量所需的网络分段。这对于AI工厂等编排优先架构至关重要。
BIG-IP Next for Kubernetes让NetOps能够以简化的方式声明Kubernetes命名空间与网段之间的映射关系。AI工厂网络与BIG-IP Next实例之间的动态路由对等互联采用熟悉的路由配置语法。NetOps团队具备特有的能力,可安全地对集群入站和出站的实时网络流进行故障排查。SecOps团队可获得针对每个集群租户的入站和出站防火墙访问控制列表(ACL)、分布式拒绝服务(DDoS)防护及IPS功能。
对于平台工程团队,BIG-IP Next for Kubernetes通过卸载数据入站和出站流量处理、源NAT及防火墙等网络功能,减轻计算资源负担。这有助于降低运营成本,同时保持服务的可用性和高效运行。
BIG-IP Next for Kubernetes还支持Kubernetes Gateway API,这是首个针对NetOps、平台工程、DevOps和MLOps中特定组织角色建模的社区入口API。通过Gateway API,BIG-IP Next for Kubernetes将典型的基于第4层端口或第7层HTTP(S)路由的入口服务扩展为面向DevOps和MLOps的一组服务,即TCPRoute、UDPRoute、HTTPRoute、TLSRoute和GRPCRoute。这些服务均通过主流AI框架中的同一套CI/CD自动化机制进行控制。
从管理角度看,BIG-IP Next for Kubernetes通过Kubernetes API声明,让NetOps、SecOps、平台工程、DevOps和MLOps团队保持高效协作。它以Kubernetes的方式提供您期待的BIG-IP各项能力,同时支持网络分段。
DPU的兴起
数据处理单元(DPU)在AI工厂中的应用呈指数级增长。正如AI工厂系列此前的一篇博文所述,DPU是一种可编程处理器,旨在通过硬件加速,以网络线速执行海量数据传输与处理。通过F5的产品创新以及与NVIDIA的合作,我们推出了BIG-IP Next for Kubernetes,使用NVIDIA的DOCA API将其部署到NVIDIA BlueField-3 DPU上,以卸载入站和出站流量的数据流,同时支持网络分段和安全功能。这确保了AI集群获得充足的数据供给,从而充分发挥AI工厂的投资价值。
由F5赋能的AI工厂
投资AI工厂时,必须确保基础设施经过优化、高效且可扩展。部署在NVIDIA BlueField-3 DPU上的F5 BIG-IP Next for Kubernetes可提供动态GPU和计算资源调度所需的网络分段,同时提供高性能扩展能力,充分提升AI投资回报。如需了解更多信息,请联系F5,与您的F5客户经理以及解决方案工程师或架构师沟通。
想进一步了解AI工厂?欢迎阅读AI工厂系列博客中的其他文章:
- 什么是AI工厂?›
- 面向AI工厂的检索增强生成(RAG)›
- 优化AI工厂数据摄取的流量管理 ›
- 优化边缘数据源与AI工厂的连接 ›
- 多云可扩展性和灵活性为AI工厂提供支持 ›
- NVIDIA BlueField DPU对AI工厂的价值与意义 ›
- 面向AI工厂的API保护:迈向AI安全的第一步 ›
- AI工厂打造现代应用的新形态:AI应用 ›
关于作者
相关博客文章

Thingbot正转变为攻击平台
Lori MacVittie重点介绍了F5 Labs对2018年1月至6月全球物联网设备攻击的研究,并指出了其中令人警醒的影响。物联网设备不仅持续遭到利用,还被转变为攻击平台,这意味着攻击者可以更充分地利用这个必然增长的市场。
借助F5全新Quick Start,在AWS上快速开展业务
在AWS re:Invent开幕前,我们很高兴与大家分享F5与AWS之间全新的Quick Start集成。F5的Tom Atkins将介绍该服务如何启动、配置和运行在AWS上部署工作负载所需的计算、网络、存储及其他AWS服务。