大多数组织并未事先规划生成式AI的上线。一个团队搭建了聊天机器人,另一个团队将模型接入内部数据,如今已有智能体在生产环境中悄然调用工具。在从试点快速推进到部署的过程中,安全工作不知不觉落在了后面,只能奋力追赶。
F5白皮书《保护生成式AI:30-60-90天框架》旨在弥补这一缺口。该框架不将AI安全视为采购清单上的一个勾选项或一次性审计,而是规划了一条循序推进的90天路径,引导团队从保护单个应用开始,逐步实施覆盖整个应用群的安全计划,进而保护自主智能体。
那么,这个框架具体是什么样的?
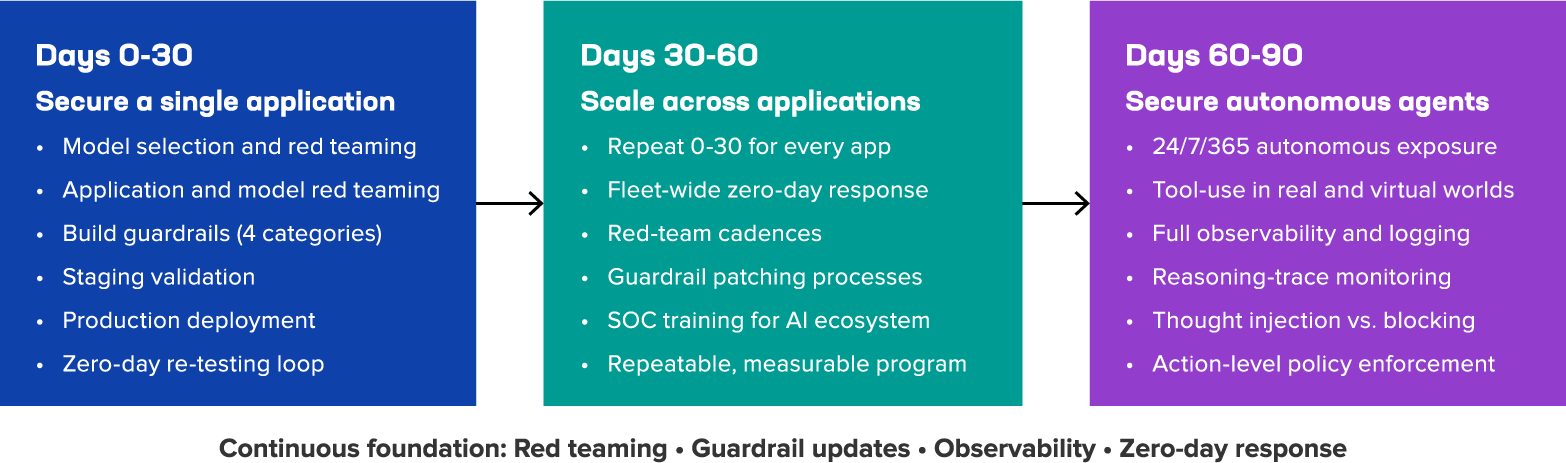
第0至30天重在规范执行,而非部署速度
面对任何新的GenAI应用,人们往往急于将其上线。但我们的AI安全框架要求采取不同的第一步:将模型选择、红队测试和护栏设计视为前30天的核心工作,而非需要设法克服的阻碍。
这意味着先对模型本身开展红队测试,建立安全基线,再基于该模型构建应用,然后对组合后的系统开展红队测试,以评估应用提升还是降低了安全性。同时,还需要围绕现有法规、AI专项法规、用例威胁和红队测试发现这四个不同类别构建护栏,避免因某项问题无法明确归入某一类别而将其遗漏。
第一阶段的产出是一套可重复执行的循环流程:出现新的零日威胁时,再次开展红队测试、修补防护措施、验证并重新部署。
第30至60天:将单个应用的安全防护扩展为系统性计划
为一个应用提供良好的安全防护,是不错的成果。但要以同样的方式、同样的节奏,为20个应用提供安全防护,并保持相同的可审计性,则是一个截然不同的问题。大多数组织正是在这一步停滞不前。
我们的框架包含四大支柱,可将临时性的安全工作转变为可规模化实施的安全计划:
- 明确与风险等级相对应的红队演练频率
- 建立防护栏补丁流水线,支持同时为多个应用部署更新及回滚
- 建立覆盖全部应用的零日漏洞响应流程,并制定切实可行的SLA
- 为SOC提供培训与支持,使安全运营人员能够像调查其他威胁一样熟练地调查AI事件
当组织能够明确每个AI应用的负责人及其上次测试时间时,第二阶段即告完成。
第60至90天:应对性质截然不同的风险
自主智能体不只是回答问题,还会持续运行,对多步骤计划进行推理,并通过工具执行实际操作。这意味着,为请求-响应式应用构建的安全模型无法直接适用于自主智能体。
我们的框架围绕两个核心思路应对这一问题。首先,可观测性必须从记录结果扩展到记录推理过程:将智能体的每个想法、每次工具调用和每项决策关联起来,使事件发生后的复盘不仅能还原发生了什么,还能还原事情如何发生。其次,当智能体的推理偏向有风险的方向时,直接阻断该想法往往会导致智能体在任务中途停止正常运行。因此,该框架提出采用思维注入,用更安全的想法替换有风险的想法,让智能体继续有效执行任务,同时配合动作级控制措施,例如工具权限和针对高影响操作的审批关卡。生成式AI安全并非达到某个里程碑后就能一劳永逸,而是一种持续的运作节奏。该框架旨在帮助安全团队在AI部署中的缺口演变为安全事件之前,建立这种节奏。
阅读我们的白皮书,了解完整的30-60-90天框架,其中包含团队可立即使用的第1至第3阶段检查清单。同时,别忘了报名参加我们即将举办的网络研讨会。
关于作者
相关博客文章

WAF和API发现技术在保护智能体AI应用中的作用
智能体AI系统的功能和集成会在运行时快速变化。要以同样的速度保障其安全,需要通过API发现和Web应用防火墙(WAF)实施切实可行的控制措施。